最も希少なデータには、二人の人間が写っている
ロボティクスとフィジカルAIの勝者はデータが決める。最も価値があるのは、人が一緒に働く姿をあらゆる方向から捉えたデータだ。それはほとんど存在しない。
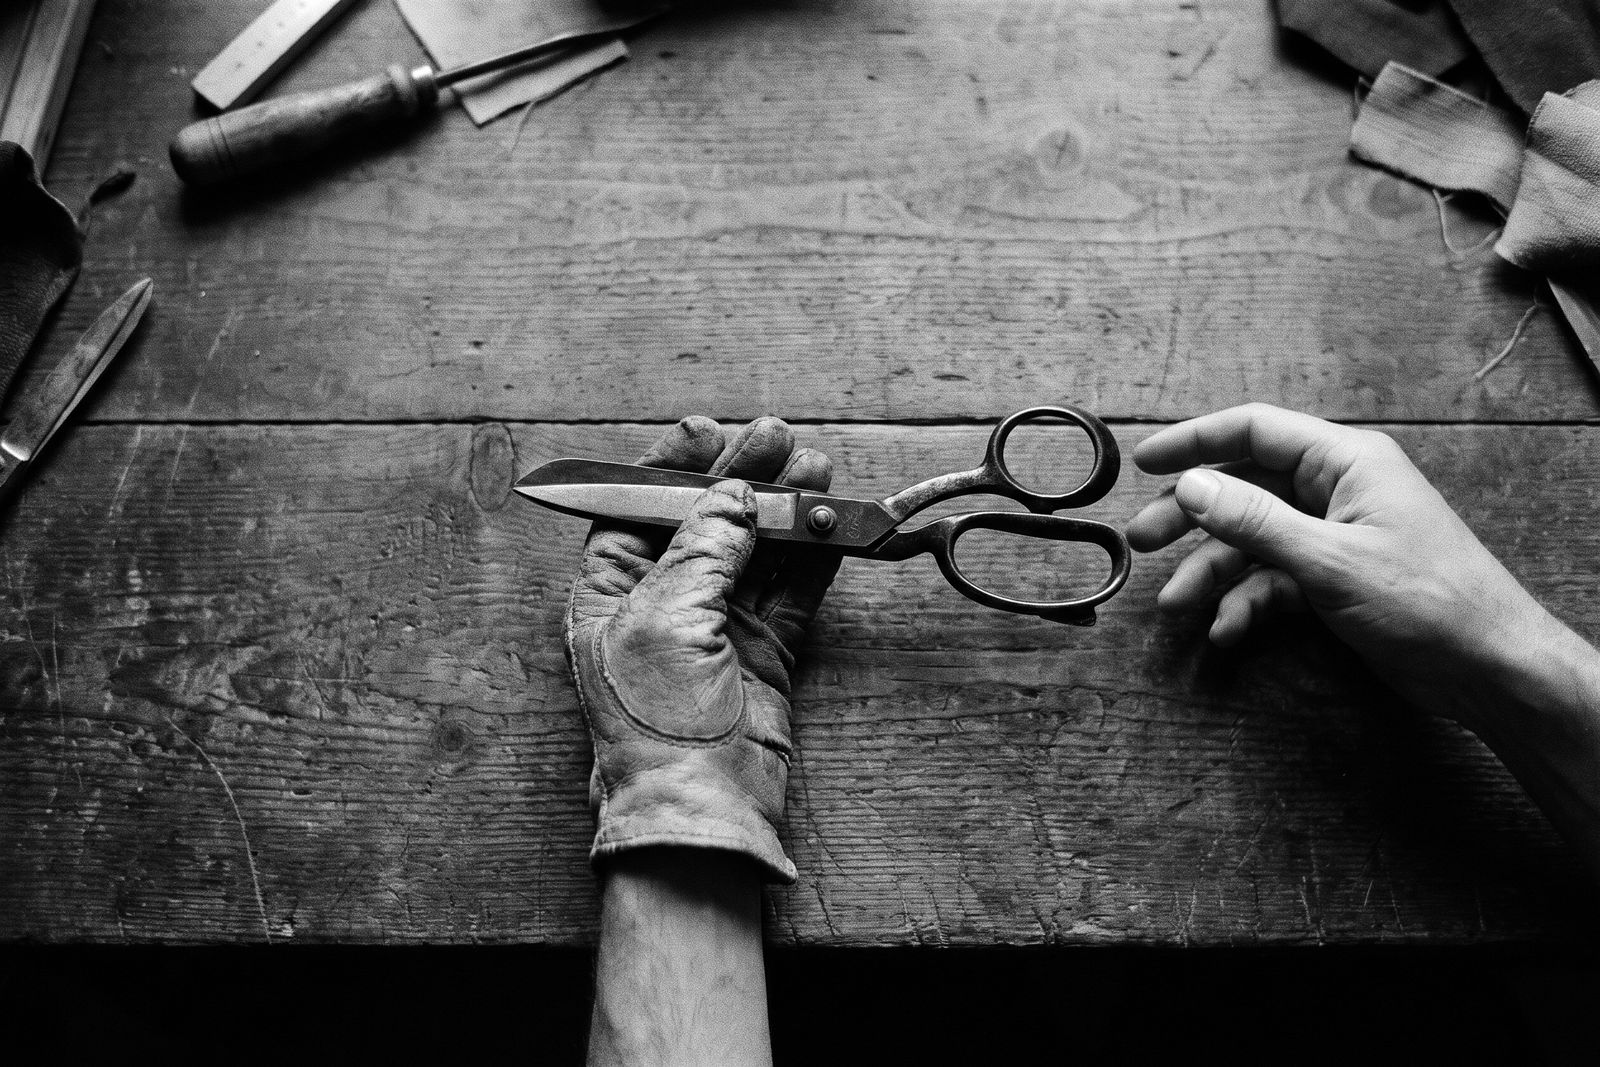
誰かにはさみを渡してみてほしい。考えもせずに持ち手を相手のほうへ向けるはずだ。相手はこちらが向け終わる前に手を伸ばし始め、こちらは相手が握ったと感じた瞬間に手を放す。誰もひと言も話さない。このやりとりはおよそ1秒で終わる。そしてロボットにとっては、いまも難しい。
機械は見せられたものを学ぶ。そしてこれを機械に見せた人は、ほとんどいない。AI企業はいまやデータに何十億ドルも払い、正確なデータほど高く買う。最も価値があるのは、二人以上の人間が写っていて、あらゆる方向から捉えたデータだ。実際上、そういうデータはまだ存在しない。
お金が語ること
2025年6月、MetaはScale AIの株式49%に143億ドルを払った。Scaleはチップもつくらないし、有名なモデルも持っていない。学習データを整える会社だ。
2026年3月、Metaで10年以上AI研究を率いたヤン・ルカンは、新会社AMI Labsのために10億3000万ドルを調達した。ヨーロッパで過去最大のシードラウンドで、調達前の評価額は35億ドル。Nvidia、Samsung、ジェフ・ベゾスのファンドなどが出資者に名を連ねた。AMIがつくっているのは世界モデルだ。カメラなどのセンサーから物理世界のふるまいを学び、それを使って次に何をするかを計画するシステムである。出発点は言語ではない。
ルカンは好んで一つの計算でこれを説明する。大規模言語モデルの餌であるインターネット上の公開テキストをすべて合わせると、約100兆バイトになる。4歳の子どもはおよそ1万6000時間起きていて、その間にほぼ同じ量が目を通して脳に届いている。子どもはさらに、どのページにも書かれていないことも学ぶ。たとえば、コップは手を放すと落ちるということだ。
体を使う仕事には、ウェブに相当するものがない。業界は力ずくでそれをつくろうとしている。2023年、Google DeepMindとそのパートナー、計21の機関は、60のデータセットを持ち寄ってOpen X-Embodimentにまとめた。22種類のロボットにわたる、100万を超えるロボット動作の記録が収められている。
2025年11月、スタートアップのGeneralist AIは、自社のモデルGEN-0を27万時間分の実際のマニピュレーションで訓練したと発表した。家庭、倉庫、職場で集めたもので、週に1万時間ずつ増えているという。ヒューマノイドをつくるFigureは、10万戸を超える住宅を保有する不動産グループBrookfieldと契約し、その中の日常生活を撮影することにした。Figureのロボットはその後、人間の動画だけから、散らかった部屋の中を進む方法を学んだ。どの会社も、モデルは1年でつくり直せるが、よい記録はそうはいかないという方に賭けている。
量より濃さ
時間数は大ざっぱな尺度だ。動画には、カップを握る手が映る。だが手がどれほどの力で握ったか、カップの重さ、蓋が閉まったことを告げるカチッという音、その0.5秒前に目がどこへ向いたかは映らない。そのそれぞれが別々のチャンネルであり、それらすべてを同時に受け取るモデルは、ただの動画をどれほど集めても教えられないことを学ぶ。
Metaはこれを早くから理解していた。15の大学と共同で構築したEgo-Exo4Dは、料理人、クライマー、ダンサー、自転車整備士など800人を超える熟練者を記録した。各人がカメラ付きの眼鏡をかけ、外からも別のカメラが撮影した。眼鏡はさらに7チャンネルの音声、モーションセンサー、視線計測、部屋の3Dマップを加えた。合計は1300時間近い。小さな数字だが、その1時間1時間が、ただの動画の1時間よりはるかに多くを語る。
デザイナーはこの原則を図面から知っている。寸法の入ったスケッチなら、つくることができる。寸法のない美しいレンダリングでは、つくれない。私なら、緩い1000時間より、正確な10時間を選ぶ。
一組の目は部屋ではない
こうしたデータのほぼすべてに、共通の限界がある。写っているのが一人だということだ。カメラは一人の頭に載り、一組の手を見ている。Ego-Exo4Dでさえ、たいていは一度に一人の熟練者を追っている。
実際の仕事が一人で行われることはまれだ。二人の看護師が患者の体の向きを変える。一人の料理人が盛り付けをし、もう一人がデシャップで声を出す。二人の取り付け職人が窓を抱えて階段を上る。こうしたことを成り立たせているものは、どちらの視界にもない。どちらかの頭に載ったカメラはその半分を記録し、相手に待てと伝えた目くばせや半歩を取り逃がす。信号は二人の間で起きることの中にある。誰が見て、誰が待ち、誰が譲るのか。そしてそれがいつなのか。
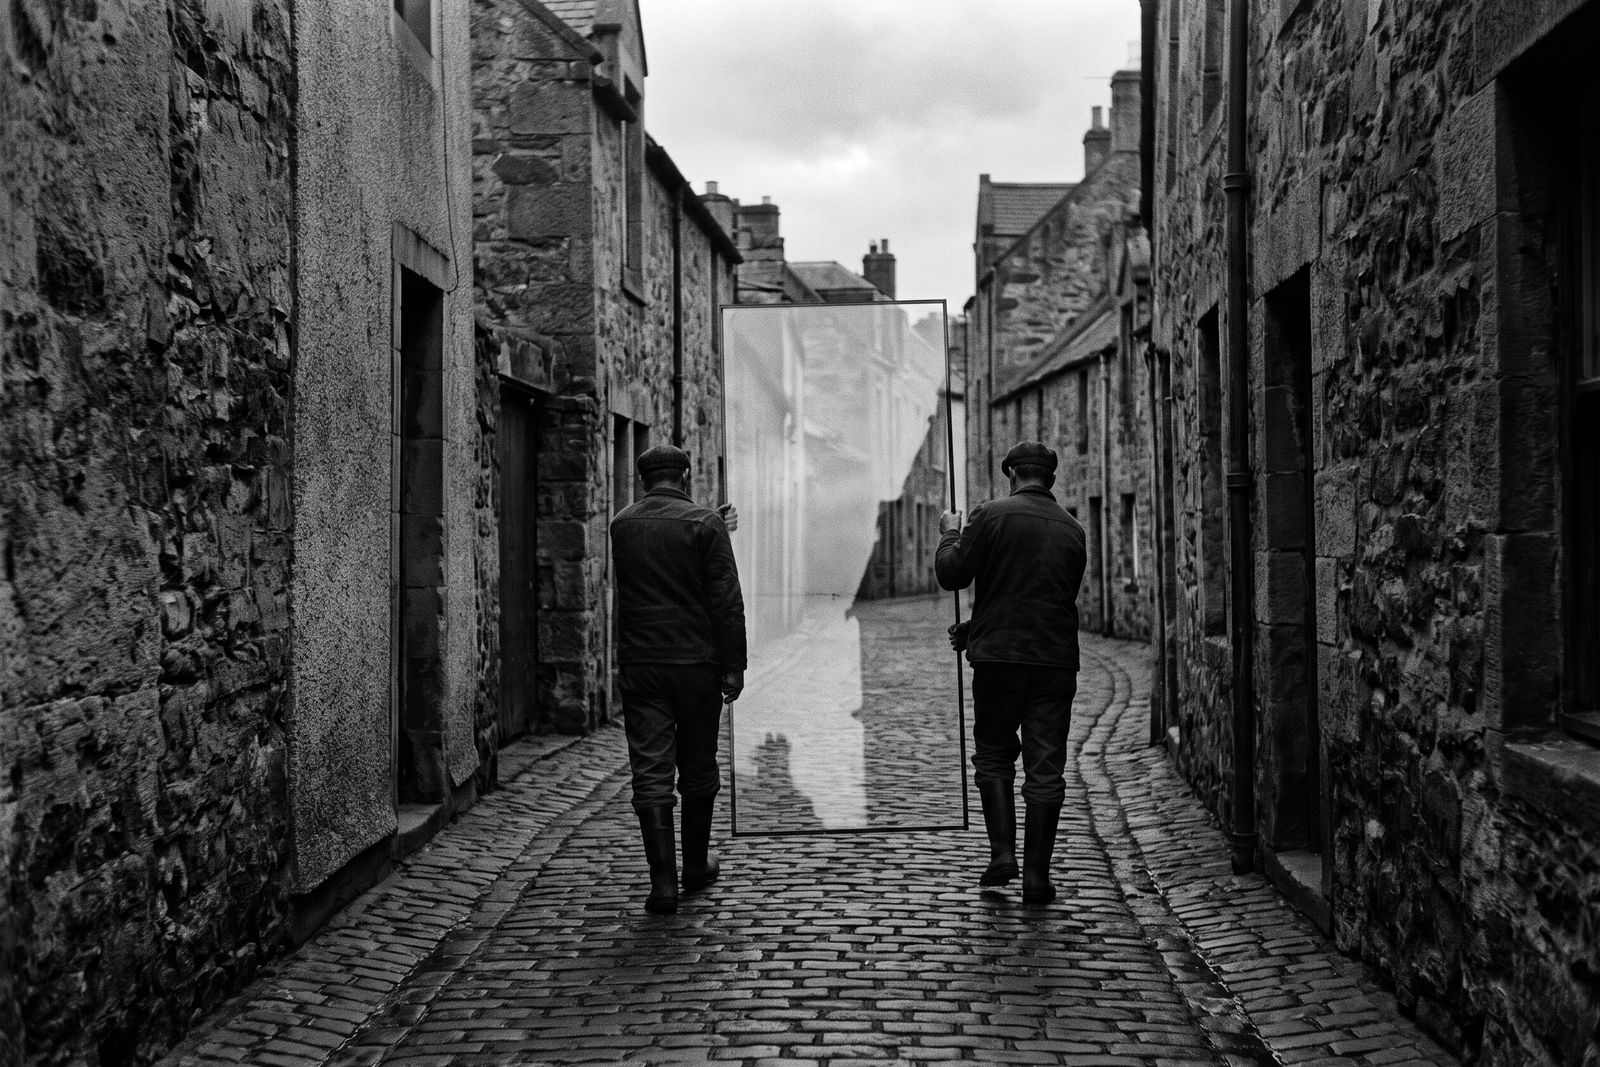
それを学ぶには、機械は二つの視点を、同じ瞬間にそろえて、まわりの部屋ごと受け取らなければならない。ロボットは家庭や病院や工房で、人のそばで働くことになっている。そこでロボットが一人になることはない。だから、いつ待ち、いつ手を放すかを知らなければならない。
それはほとんど記録されていない。2023年、MicrosoftはHoloAssistを公開した。一人がある作業をし、もう一人がそれを指示する様子を収めた166時間のデータだ。二人目は離れた場所にいて、一人目のヘッドセットを通して見ていた。2026年7月、チューリッヒ工科大学、Microsoft、マックス・プランク情報学研究所、ミュンヘン工科大学の研究者がCoMindを発表した。二人一組が本物の台所で一緒に料理をする。それぞれがカメラ付きの眼鏡をかけ、さらに2台のカメラが部屋を見渡し、視線、手、発話がすべて記録される。著者たちは、一人の視点からのデータセットは豊富にあるが、人々が一緒に働く様子を扱うものは少なく、大半は主な行為者を切り離して扱っていると指摘している。彼ら自身のデータセットは収録80本、41時間だ。
41時間。一つのスタートアップが集めた27万時間のマニピュレーションと並べてみるといい。比率は6500対1を超える。
誰が撮るのか
この差はデータセンターからは埋まらない。人が一緒に働き、記録されることに同意している部屋が要る。目的に合わせて選んだセンサーと、一つの時計にそろえたすべてのストリームが要る。時間がかかり、体を動かす仕事だ。だからこの差はまだ開いたままなのだ。私が創業したOptAIは、世界モデルのラボを自前で持つチューリッヒのAI企業だ。私たちのものも含めて、記録が取りこぼしたものを埋め合わせられるモデルはない。
同僚のようにこちらの手からはさみを受け取る最初のロボットは、二人の人間がそうする様子を両側から同時に撮った記録で、そのやり方を学んでいるはずだ。
Rea Starkはチューリッヒを拠点とするインダストリアルデザイナーであり、起業家である。SonyやNespressoのデザインを手がけ、Piëch AutomotiveとArchaí Physicsを共同創業した。機械が物理的な世界をどう知覚し、どう扱うかに取り組んでいる。Rea Starkに
このエッセイの画像はAIで生成したものです。